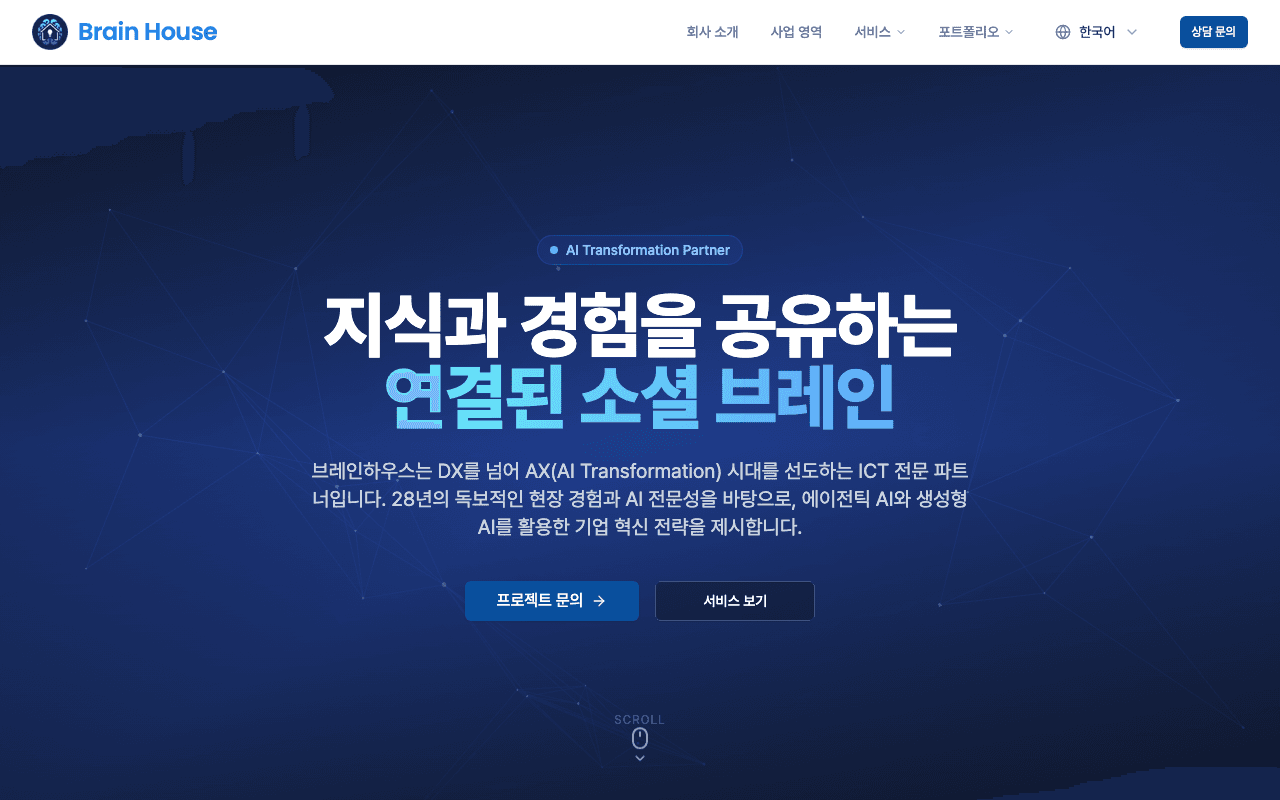
brainhouse.kr
Brain House
AI·ICT 컨설팅 회사의 소개 사이트입니다. 한국어, 영어, 일본어로 볼 수 있고, Three.js로 만든 3D 요소와 문의 메일 발송을 넣었습니다.
외부 의뢰 · 2025.12 ~ 2026.02 · 커밋 74개
- Next.js 14
- TypeScript
- Tailwind CSS
- Three.js
- Resend
 Jake
직접 설계·개발·배포한 서비스 세 개입니다. 세 곳 모두 지금 열어보실 수 있습니다. 의뢰받아 만든 사이트 두 개도 함께 싣습니다.
콘텐츠 큐레이션 플랫폼
흩어진 관심사를 한곳에 모으는 콘텐츠 큐레이션 플랫폼
2026.09 ~ 현재 · 개인 프로젝트 (풀스택)
보시는 방법
회원가입하시면 링크 주소만 넣어 AI가 설명과 카테고리를 채워 주는 기록(레코)을 직접 만들어 보실 수 있습니다(가입 시 AI 크레딧 30개 지급)
모노레포 구조 - NestJS + Next.js Turborepo 모노레포로 백엔드/프론트/워커 앱을 나누고, 공유 패키지(zod 스키마·타입)로 프론트·백 검증을 일원화했습니다.
인증·권한 시스템
백엔드 설계
도메인 설계
프론트엔드·배포 - Next.js 16(App Router) + React Query + Tailwind/shadcn, 다국어(i18n) 구조 설계(한·영 적용, 13개 언어 확장 가능), Vercel 배포
인프라 - 본인 AWS 계정에 직접 구축했습니다. EC2 1대에 Nginx·백엔드·워커·Redis·MySQL을 Docker 컨테이너로 올려 RDS 비용을 줄이고, GitHub Actions(OIDC)로 ECR 이미지를 빌드해 백엔드·워커를 자동 배포합니다. DB는 매일 S3로 백업합니다.
기획·디자인·개발·인프라·운영을 혼자 맡아 공개한 서비스입니다.
Recueve의 저장 단위를 '레코'라고 부릅니다. 사용자가 URL 하나만 붙여넣으면 자막·본문을 읽어 카테고리·설명·노트를 생성해 레코를 채우는데, 이때 AI 사용 크레딧이 하나 소모됩니다. 즉 LLM 호출이 곧 돈이 나가는 트랜잭션입니다. 그래서 정산 시스템을 만들 때와 같은 방식으로 접근했습니다.
| 단계 | 처리 |
|---|---|
| ① 크레딧 1개 차감 | Prisma 트랜잭션 + SELECT FOR UPDATE row lock |
| ② BullMQ 큐 적재 | AUTO_FILL_QUEUE (백엔드 → 워커 분리) |
| ③ 캐시 확인 | (uriHash, locale) 키로 조회→ 있으면 자막 추출·설명 생성을 건너뛰고 카테고리·노트만 재생성 |
| ④ 자막 추출 | yt-dlp |
| ⑤ 입력 크기 판단 | chars/4로 토큰 추정 → 8,000 초과 시 Haiku로 1차 요약 |
| ⑥ 제안 생성 | Sonnet이 카테고리·설명·노트 생성 |
| ⑦ 실패 시 환불 | 워커 → 백엔드 internal webhook → 크레딧 환불 |
| 문제 | 처리 |
|---|---|
| 긴 자막의 비용 | 8,000 토큰이 넘으면 Haiku로 먼저 요약하고 Sonnet에 넘깁니다. 싼 모델로 줄이고 비싼 모델은 판단에만 씁니다 |
| 입력마다 다른 상황 | 소스를 5종으로 나눠 폴백합니다 - 자막 → 페이지 본문 → 설명문만 → 캐시된 설명 → 자막 없음(이 경우 LLM을 아예 호출하지 않습니다) |
| 같은 URL 중복 호출 | (uriHash, locale) 캐시에 사용 모델과 프롬프트 버전까지 저장합니다. 프롬프트를 고치면 버전으로 구분됩니다 |
| 실패했는데 돈만 나감 | LLM 호출 실패 시 자동 환불. 재전송·재시도로 중복 환불되지 않게 멱등 처리(이미 환불된 건이면 잔액만 반환) |
| 호출했는데 못 만든 경우 | 자막 없음은 LLM을 호출하지 않았으므로 환불 대상에서 제외합니다. 돈이 나간 것과 안 나간 것을 구분합니다 |
| 재시도가 오히려 위험 | YouTube 차단 위험 때문에 재시도를 1회로 고정했습니다. 무조건 재시도가 답이 아닌 경우입니다 |
| 분류할 카테고리가 없음 | 사용자 카테고리 트리(Materialized Path)를 우선 쓰고, 적합한 게 없으면 시스템 canonical 트리로 폴백 분류 |
| 모델 교체 | 모델 ID를 시스템 설정에서 주입할 수 있게 하고, 없으면 환경변수로 폴백 |
정산 엔진에서 하던 것(트랜잭션·원장·멱등성·실패 복원)을 LLM 호출에 그대로 적용했습니다. AI 기능을 붙일 때도 돈과 상태가 어긋나지 않게 만드는 것이 먼저라고 봤습니다.
결과는 서비스에서 볼 수 있습니다 - 모두의 레코스 (새 창)의 각 레코에 붙은 카테고리 태그와 설명 본문이 이 파이프라인의 산출물입니다.
MLM 정산 솔루션
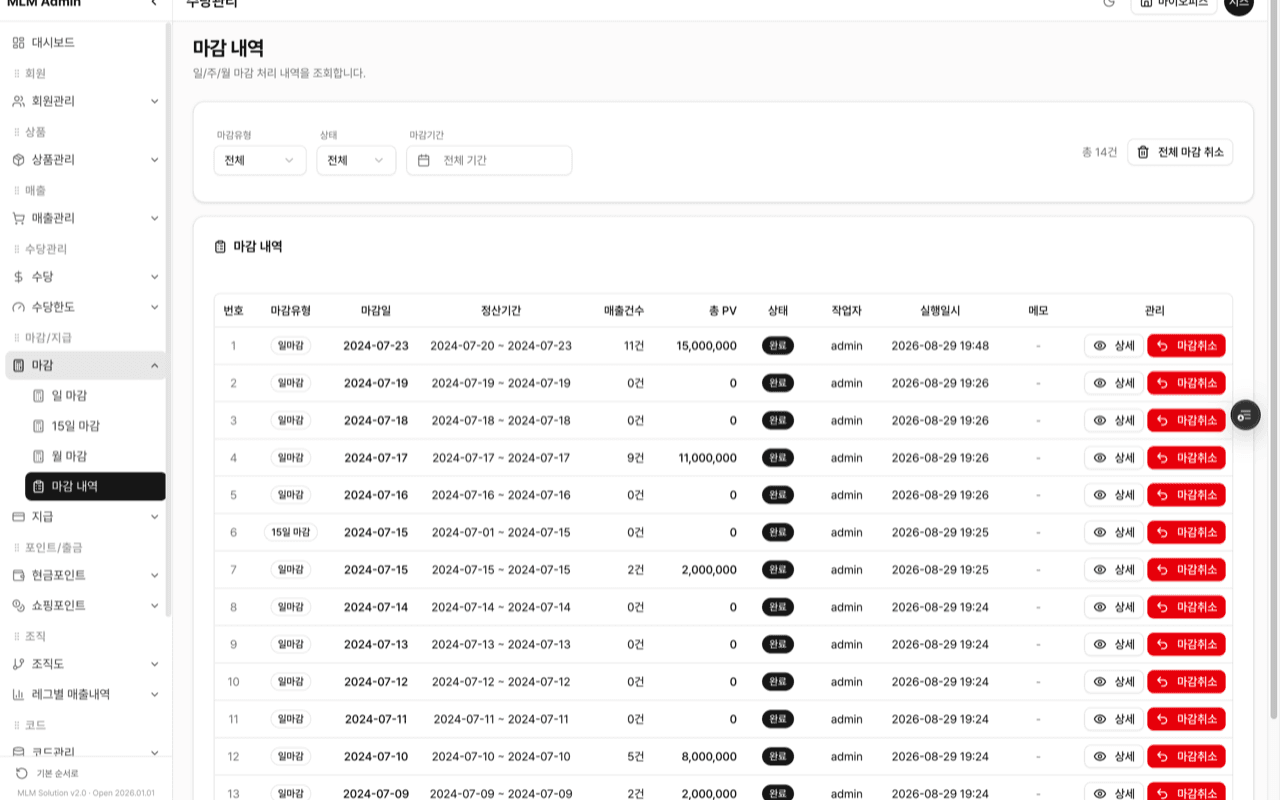
보상플랜과 쇼핑몰을 설정으로 켜고 끄는 MLM 정산 솔루션
2025.12 ~ 2026.01 · 프리랜서 프로젝트 (풀스택)
보시는 방법
첫 화면이 쇼핑몰입니다. 오른쪽 위 로그인 → DEMO Login에서 일반회원으로는 주문을 해 보실 수 있고, 시스템 관리자로는 계정 없이 모든 설정 기능을 보실 수 있습니다. 회원·상품·매출은 시드 데이터이고, 마감 결과는 그 데이터로 정산을 실제로 돌려 나온 값입니다
정산 엔진 - 여기가 이 프로젝트의 심장입니다.
"최대"인 이유가 이 프로젝트의 핵심입니다. 마감 유형과 수당 종류를 코드가 아니라 설정으로 켜고 끕니다. 업체마다 보상플랜이 다르기 때문에, 만들어둔 것을 업체별로 필요한 것만 활성화합니다. 새 수당이 필요해지면 종류가 늘어나는 구조입니다. 데모에서 직접 확인하실 수 있습니다 -
마감에는 일/15일/월 3종만 떠 있는데, 주 마감을 시스템 설정에서 비활성화했기 때문입니다.일 마감화면 상단에도 "데일리수당, 추천수당, 후원수당, 롤업수당이 활성화되어 있습니다. 마감 시 해당 수당들이 계산됩니다"라고 현재 활성 수당이 표시되고, 비율 구간표 아래에는 "비율 변경은 시스템 설정 → 보상플랜 → 데일리수당에서 가능합니다"라고 설정 경로가 안내됩니다.
쇼핑몰 - 설정으로 켜는 옵션이고, 정산 로직은 건드리지 않고 붙였습니다.
동적 시스템 설정 엔진
멀티테넌트 아키텍처
api.{도메인}으로 라우팅백엔드·회원 시스템
구현만 AI에게 맡기지 않고 검증까지 맡겼습니다. 대신 합격 기준은 코드로 고정했습니다.
ProWith를 운영하면서 정작 시간을 잡아먹는 건 코드가 아니라 운영이라는 걸 알게 됐습니다. 특히 세 가지가 그랬습니다.
정산 검증   수당 최대 13종 × 마감 최대 4종(일/주/15일/월)
신규 업체   DB·GitHub·AWS·Vercel 구성 + 도메인 연결 + 배포를 매번 손으로
보상플랜    업체마다 다른 규칙을 hwp·pptx 문서로 받아 코드로 옮기는 작업
그래서 반복 운영 업무를 재현 가능한 스킬 6종으로 고정했습니다. 매번 같은 결과가 나오는 작업 절차입니다.
| 스킬 | 하는 일 |
|---|---|
신규 업체 셋업new-tenant | 명령 한 번으로 디렉토리 복제 → 로컬 DB·Prisma → GitHub 레포 → AWS(ECR·RDS·SSL·Secrets) 배포 → Vercel 프론트 + 도메인 연결까지. 직접 하는 건 DNS 설정 정도입니다 |
보상플랜 문서화compose-plan | 원본 자료(PPTX·HWP·PDF·이미지)를 읽어 검증 스킬이 그대로 읽을 수 있는 규격 문서로 정리합니다. 자격 조건의 단위·마감 주기처럼 모호한 항목은 임의로 정하지 않고 되묻게 했습니다 |
보상플랜 반영build-seed-plan | 그 문서를 업체별 설정값으로 옮깁니다. 기본값과 같더라도 플랜이 정한 값은 명시해 둡니다 - 나중에 기본값이 바뀌어도 업체 설정이 따라 흔들리지 않게 |
마감 검증verify-cutoffs | 보상플랜 문서와 현재 설정을 읽어 합격 기준을 스스로 구성한 뒤, DB 재시드 → 테스트 매출 → 일/주/15일/월 순차 마감 → 집계 검증. 마감 취소 정합성·탈퇴자 실적 제외까지 (아래 ①) |
재마감 대조compare-recut | 운영 덤프를 2벌(동결 기준본 + 작업본) 복원해 재마감 결과를 운영 원본과 전수 비교 (아래 ②) |
업체 로고 생성build-tenant-logo | 로고 소스 이미지를 벡터화(potrace) 해 가로형 SVG·투명 PNG·favicon 자산으로 만듭니다 |
셋은 체인으로 물려 있습니다 -
compose-plan(문서화) →build-seed-plan(설정 반영) →verify-cutoffs(검증). 앞 단계의 산출물 형식을 뒷 단계가 그대로 읽도록 규격을 맞춰 둬서, 새 업체 보상플랜이 들어오면 이 순서로 흘려보내면 됩니다.
작업 절차 안에 검사 두 가지를 넣어, AI가 구현을 끝내면 스스로 돌려보고 통과해야 끝나도록 했습니다. 사람이 만든 건 검사 자체가 아니라 무엇을 통과로 볼 것인가입니다.
① 보상플랜 불변식(invariant) 검사 보상플랜이 반드시 지켜야 할 조건을 코드로 박아두고, 계산 결과가 거기서 어긋나는지 봅니다. 이때는 조건을 만족하는 테스트 데이터를 만들어내는 것 자체가 일이었습니다.
② 운영 덤프 재마감 전수 대조 실제 운영 데이터를 그대로 다시 마감시켜, 기존 결과와 전수 비교합니다. 한 건이라도 어긋나면 통과하지 않습니다.
사람이 하는 일과 AI가 하는 일 - AI 코딩 도구가 등장하기 훨씬 전부터 다양한 로직을 직접 구현해 온 경험을 바탕으로 설계 방향과 합격 기준을 정합니다. 구현·테스트·검증 실행은 AI가 맡습니다. 기준이 코드로 박혀 있으니 결과를 눈으로 다시 확인할 필요가 없어졌고, 사람이 판단할 지점만 남았습니다.
통계 분석 + AI 예측
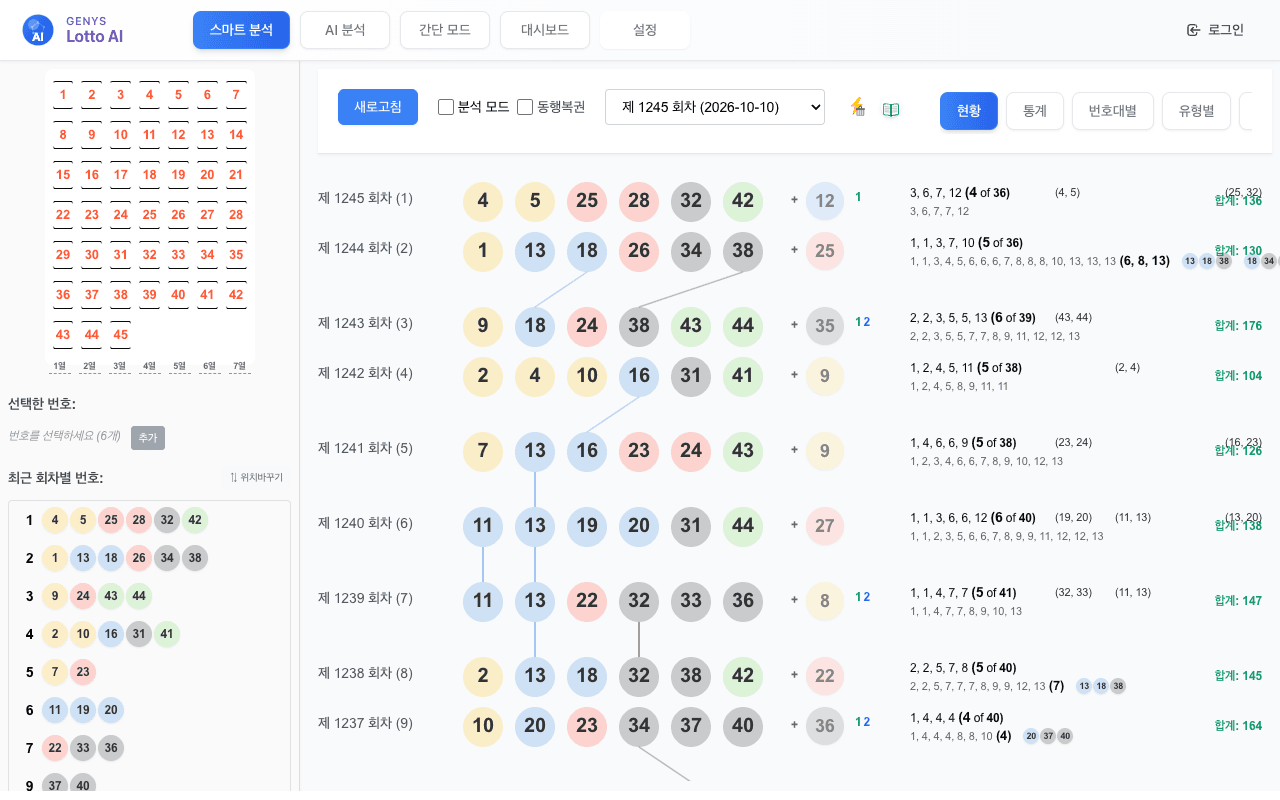
역대 로또 추첨 데이터 기반 통계적 패턴 분석과 AI 예측 모델을 결합한 서비스
2025.10 ~ 2025.11 · 개인 프로젝트 (풀스택)
보시는 방법
회원가입 후 이용하실 수 있습니다
구성 - Next.js 15 App Router 풀스택(78개 REST API) + AWS Lambda·EventBridge 수집기 + Python 예측 파이프라인이 하나의 PostgreSQL을 공유하는 구조입니다. 수집기가 매주 토요일 동행복권 회차를 가져와 저장하면, 예측 파이프라인이 다음 회차 예측을 같은 테이블에 써두고, 웹앱이 그걸 읽어 보여줍니다.
이 프로젝트에서 가장 많은 시간을 쓴 부분입니다. 한 번에 해결한 게 아니라, 병목이 옮겨갈 때마다 다른 방법을 썼습니다.
① 서버 응답이 느리다 → LRU 인메모리 캐시
9개 분석 API가 매 요청마다 전체 회차를 다시 계산하고 있었습니다. 로또는 주 1회 추첨이라 같은 범위의 분석 결과는 일주일 내내 변하지 않는다는 점에 착안해 캐시를 붙였습니다.
966ms → 31ms   (97% 개선)
백테스트 반복 분석 40% 향상 · DB 부하 90% 감소
_full(전체) · _dhl(836회~) · _{fromTurn}_{toTurn}(백테스트). 사용자가 임의 구간을 지정해도 캐시가 듣습니다CacheInvalidator.onNewDrawing()이 분석·통계·대시보드 캐시와 최신 회차 값을 한 번에 초기화합니다. 캐시는 넣는 것보다 언제 버릴지가 어렵습니다toTurn === latestTurn으로 "전체 범위 요청인가"를 판정해 캐시 키를 결정하기 때문에, stale이면 옛 회차 결과가 _full 키에 들어앉습니다. 분석 결과는 24시간, 이 값은 5분으로 나눈 이유입니다globalThis 싱글톤으로 보관② 예측 API가 10초 걸린다 → 불필요한 연산 제거 + 병렬화
캐시로 분석 API는 빨라졌는데 하이브리드 예측이 여전히 10초였습니다. 뜯어보니 원인이 둘이었습니다.
순차 API 호출 ~7s  +  백테스트 ~3s   =  약 10초
          ↓                   ↓
병렬 호출 ~2s        조건부 스킵        =  약 2초   (80% 단축)
includeStats=false로 스킵해 800ms~1s를 줄였습니다Promise.allSettled()로 병렬화 - all이 아니라 allSettled를 쓴 건 하나가 실패해도 나머지 결과로 예측을 보여주기 위해서입니다. 실패한 것만 로깅합니다③ 화면 전환이 굼뜨다 → 클라이언트 캐싱과 필터링
서버는 빨라졌는데 탭을 옮길 때마다 같은 데이터를 다시 받아오고 있었습니다. 서버 필터링을 클라이언트 필터링으로 옮기고, 조회한 회차는 Map에 담아 재사용했습니다.
API 호출     105회 → 1회    (99% 감소, 탭 5회 전환 기준)
네트워크     350KB → 50KB   (86% 절감)
탭 전환      1~2초 → 즉시
트레이드오프 - 캐시 TTL을 24시간으로 길게 잡은 대신 무효화 트리거를 정확히 걸어야 했고, 클라이언트로 데이터를 내리는 대신 첫 로딩이 무거워지는 것을 감수했습니다. 도메인 특성(주 1회 갱신, 데이터 크기 수백 KB)을 보고 내린 판단입니다.
제약 조건 때문에 버렸는데 실제로는 당첨된 조합을 기록해 추적하는 기능이 있습니다. 스키마가 자주 바뀌고 조회보다 적재가 훨씬 많은 데이터라, PostgreSQL 대신 MongoDB Atlas에 Mongoose ODM으로 따로 담았습니다.
LOG_TARGET 환경변수로 파일 / MongoDB / 둘 다를 골라 씁니다. 로컬에서는 파일, 운영에서는 MongoDB무료·프리미엄·관리자 3등급에 비로그인까지, 화면과 API 분기가 4가지입니다. 등급 하나 고칠 때마다 로그아웃하고 다른 계정으로 다시 로그인하는 게 반복돼서, 개발 모드에서만 뜨는 플로팅 계정 전환기를 붙였습니다.
role별 1명), 필요하면 전체 계정 목록을 펼칩니다. 로그아웃(비로그인 테스트) 버튼으로 비로그인 화면도 같은 자리에서 확인합니다/api/dev/force-login이 NextAuth JWT를 직접 발급해 세션 쿠키로 심습니다NODE_ENV !== 'development'면 렌더 자체를 하지 않고, /api/dev/* 라우트도 같은 조건으로 403을 돌려줍니다. 화면만 숨기면 엔드포인트는 그대로 열려 있기 때문입니다인증 및 보안 - NextAuth.js OAuth(Google/Kakao)·이메일 OTP 및 RBAC 등급별 접근 제어, Redis 인증 코드(10분 TTL), AES-256 개인정보 암호화
인프라 - Vercel + Supabase(PostgreSQL) · Upstash Redis · MongoDB Atlas · AWS Lambda·EventBridge · Vercel CI/CD
회사 소개 사이트 두 곳을 의뢰받아 만들었습니다. 두 사이트 모두 소스를 공개 저장소에 두었습니다.
AI·ICT 컨설팅 회사의 소개 사이트입니다. 한국어, 영어, 일본어로 볼 수 있고, Three.js로 만든 3D 요소와 문의 메일 발송을 넣었습니다.
외부 의뢰 · 2025.12 ~ 2026.02 · 커밋 74개
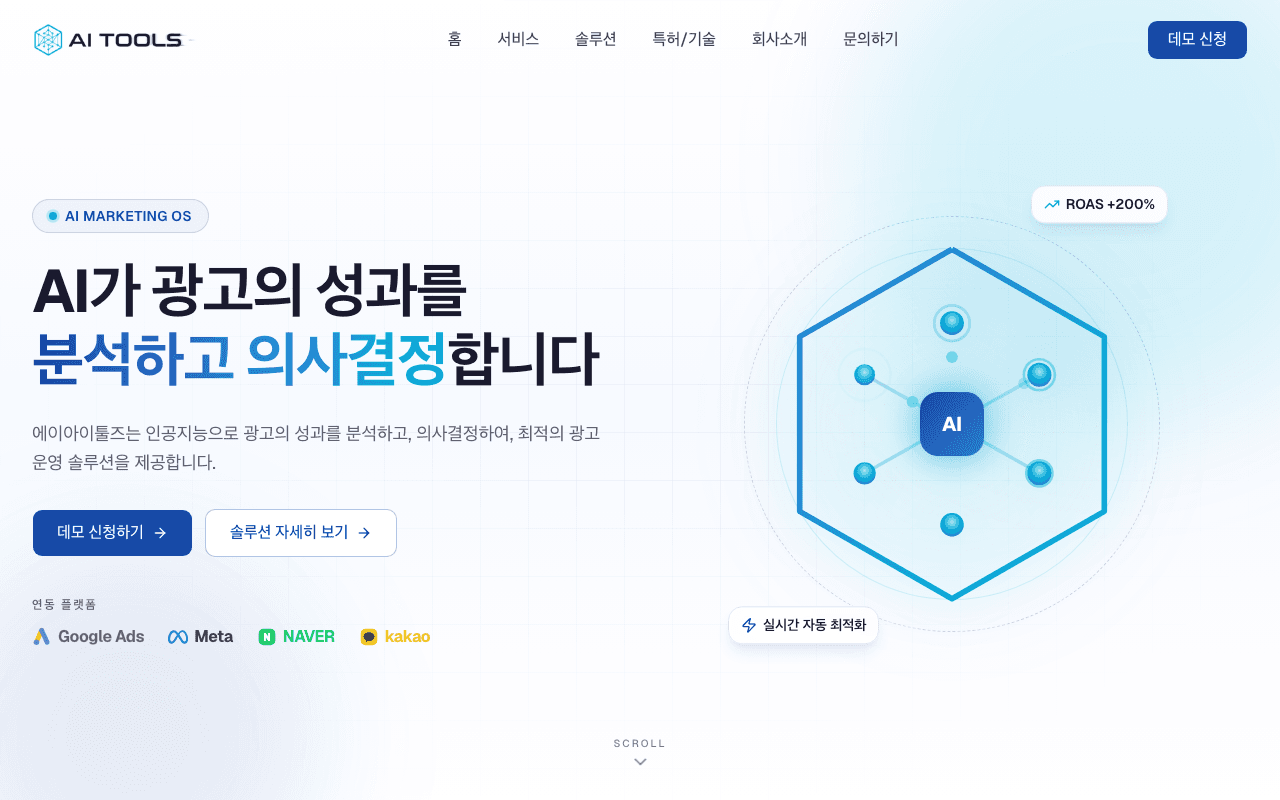
AI 광고 성과 분석 솔루션을 소개하고 데모 신청과 문의를 받는 B2B 사이트입니다. 9개 페이지를 기획서에서 배포까지 혼자 만들었습니다.
Claude Code를 활용해 기획서를 명세(SPEC.md), 계획, 태스크 문서로 옮기고, 태스크마다 타입 검사와 린트, 테스트를 통과시키며 구현했습니다.
기획서 → SPEC.md → plan.md → todo.md → 구현·검증
외부 의뢰 · 2026.06 · 구현 커밋 46개 · 첫 커밋부터 23시간